
张红甫_AI画手!卷趴的人类暗示工程师们,打工人还有未来吗?
AI画手!卷趴的人类暗示工程师们
这一次人类的画手真的要失去工作。
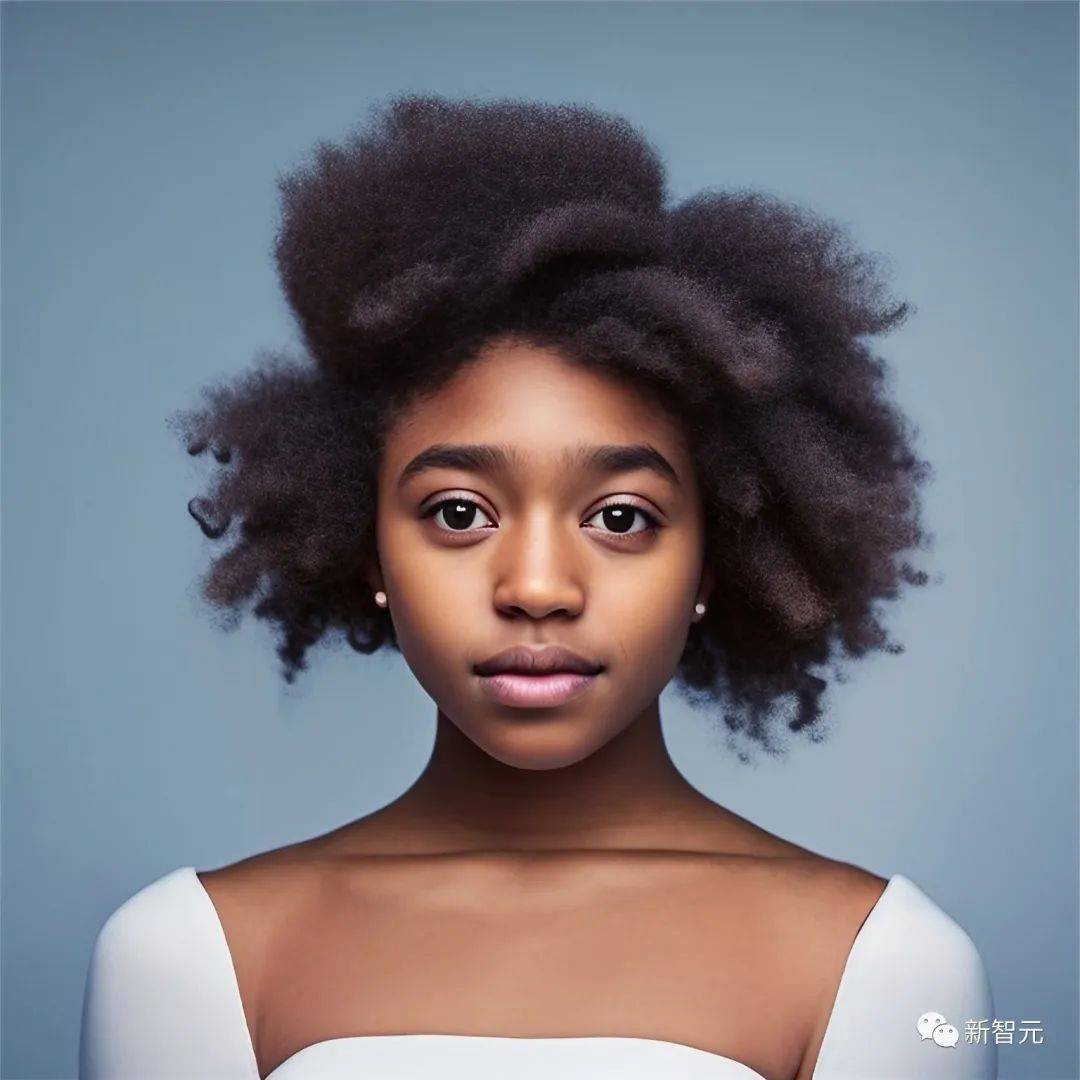
你们敢信这张像电影剧照般的照片竟是AI绘制?
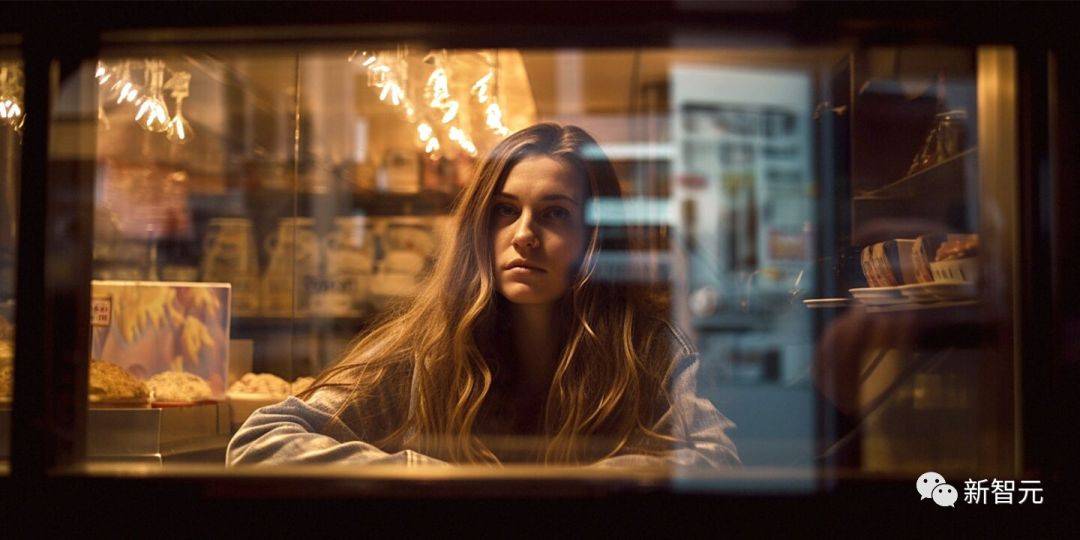
Midjourney v5所产生的光影与皮肤效果
更加邪乎,AI画手也要亲自动一番脑筋。
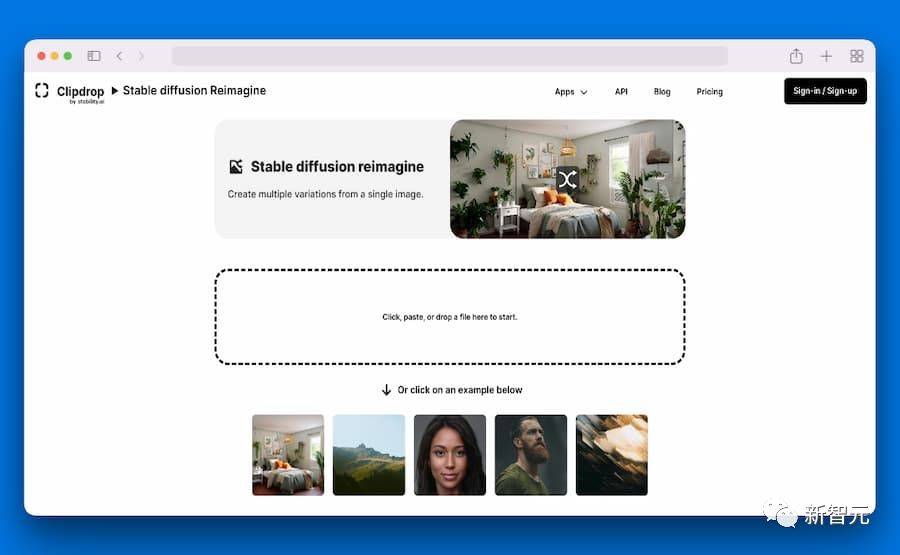
最近新出的Stable Diffusion Reimagine,就给个照片吧,它将无限地发挥想象。你可以把它做成各种风格的照片。您想要的版本有多多大,就会为您产生多大的版本。
拥有这样的AI,不管请求多么奇葩、需要修改多少遍,甲方父亲想做的计划、设计师、画手都会分分钟甩在他的身后。
logo在放大时是否可以减小一点?改!
想五彩斑斓黑色?改!
是那样的气定神闲、如鱼得水。
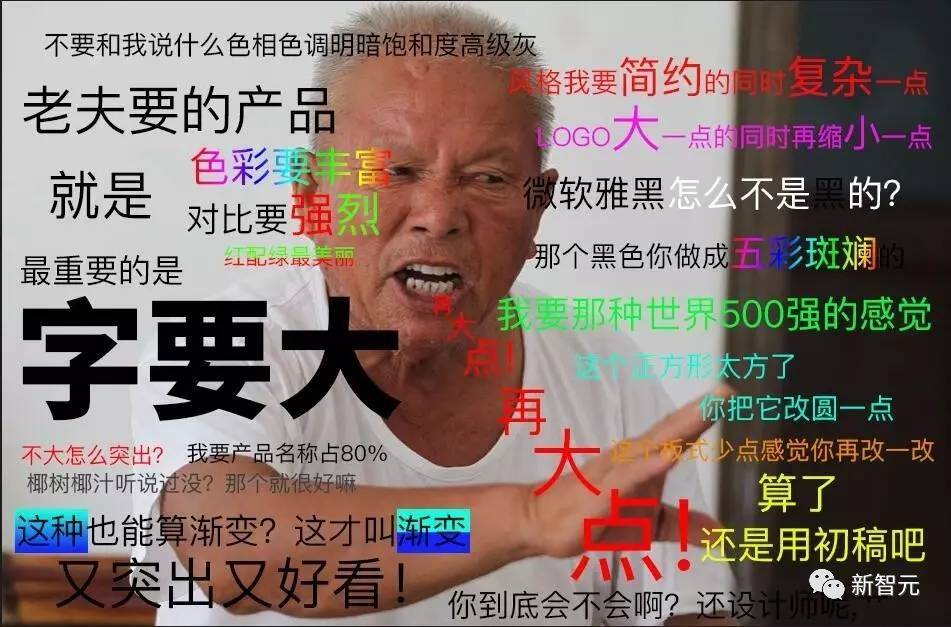
惟一需要操心的是永远不要告诉甲方父亲.
AI学着想像人类甚至会失去prompt?
Stable Diffusion是我们大家非常熟悉的AI画图工具。
昨日,Stability AI再次爆出了一条令人震惊的新闻:它把Stable Diffusion大大改进了一把。
这次新推出的产品,叫做Stable Diffusion Reimagine。
敢于呼唤Reimagine,让人听了会感到震惊。
不错,如今您只需上传一张照片,SDR便能在这张照片的基础上制作出无数新的照片。
而这正是真正意义上的想象和创造,不照搬原始图片中的脸和对象,但从原始图像中得到启示,再创造新的画面。
我们大家都知道prompt在之前AI作图工具里的品质常常决定了你能够绘制图像的最高限额。
许多人都在谈论是否要prompt,会是用AI庸人与天才分水岭。无独有偶,暗示工程师们认为prompt是他们开启AI大奖的秘密武器。
科罗拉多州去年博览会艺术比赛得主、《太空歌剧院》主创人员,你会拒绝分享你在Midjourney中使用的线索。他说,他的画是一种“伪”绘画。据说他的工作时间超过80小时,迭代900次才画完。
而且现在也不用多么繁杂prompt了,只要将一张照片扔给AI就可以,算法则能产生我们所希望的无限变化。
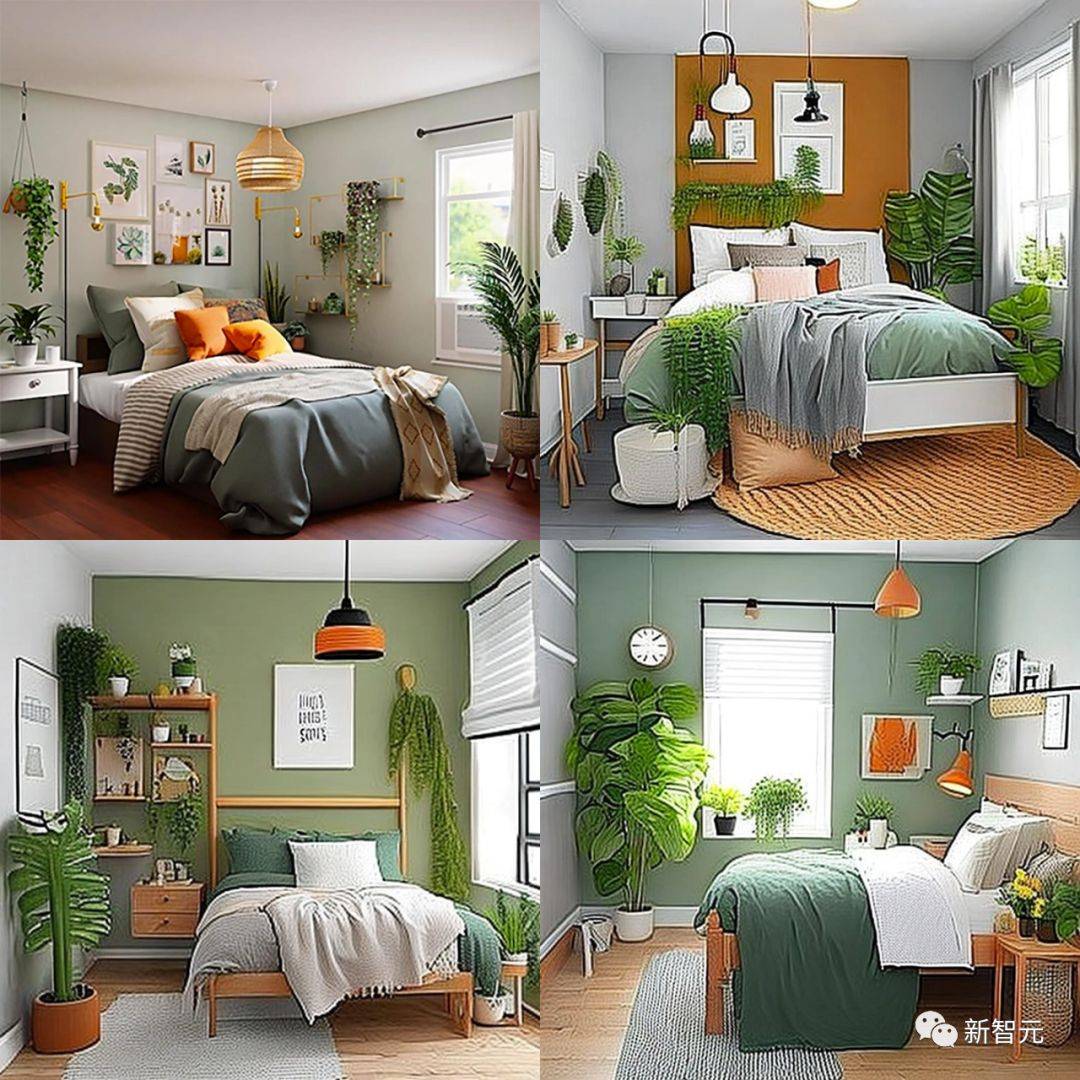
鼠标一按,居室顿时大变。
技术原理等
这个全新的Stable Diffusion Reimagine,就是在stability.ai基础上创建的新算法。
经典Stable Diffusion模型均以文本输入作为训练条件。
而Reimagine中,使用一种图像编码器来代替原文本编码器。该方法是将文本和图像结合起来进行编码的一种新技术。并非基于文本输入产生图像,但由影像产生影像。这种方法是把两个不同的编码器组合起来,并进行解码。经过编码器的算法,同时也增加了部分噪音来制造改变。
此法生成的画面在外观上类似,而在细节与构图上却不一样。
并且不同于图像对图像算法,原始图像先进行了完全编码,这就意味着生成器并没有利用从原始图像中提取出的任何像素。
并且,Clipdrop也可以增强画面的分辨率。在处理小尺寸图像时,可以将其压缩到较低压缩率,从而减少存储开销。用户只要上传小图就可以,你可以得到一幅细节水平至少是2倍的照片。
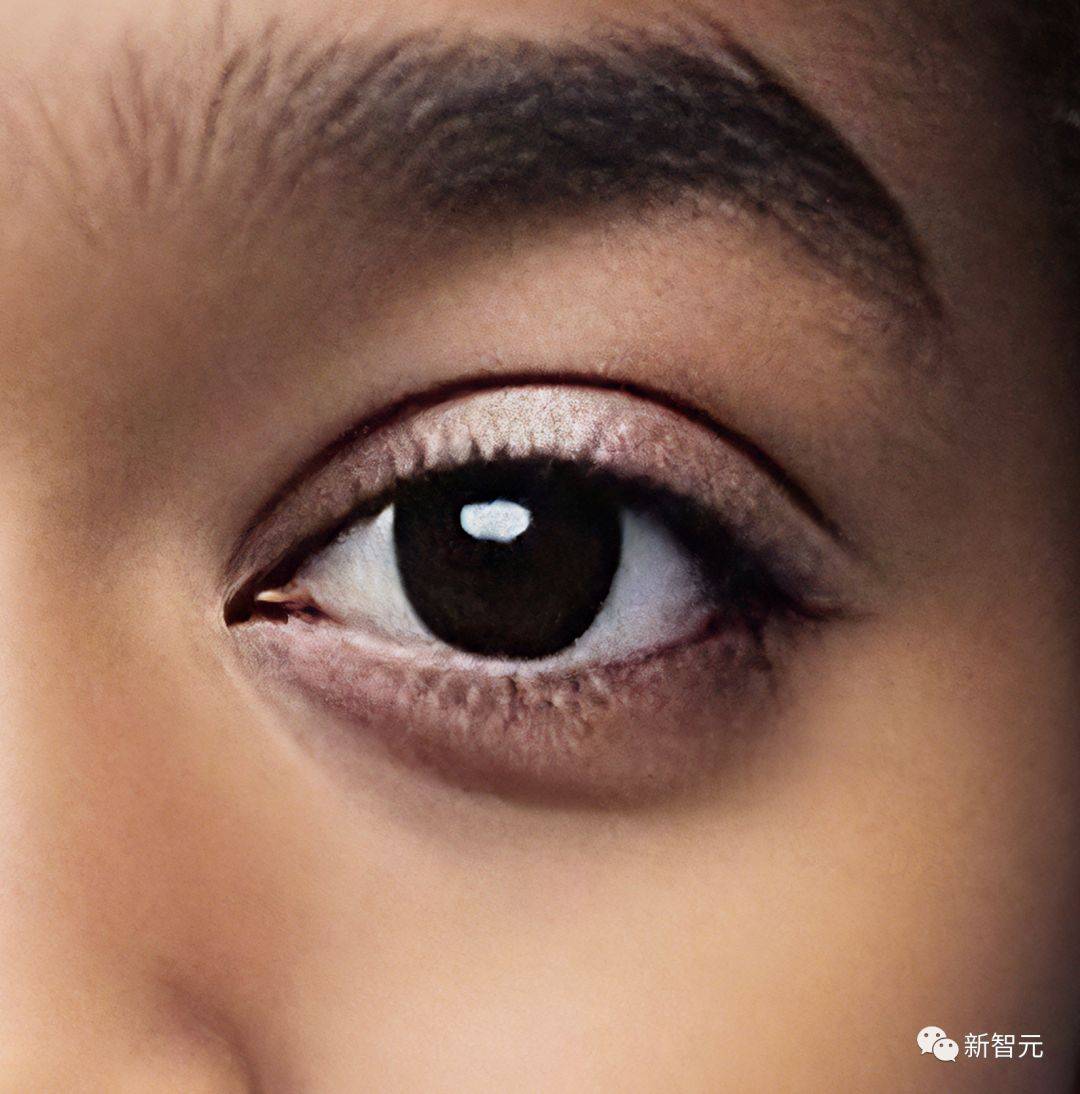
据悉,Stable Diffusion Reimagine的模型很快就会在StabilityAI的GitHub上开源了. 据悉,Stable Diffusion Reimagine的模型很快就会在StabilityAI的GitHub上开源了.
发挥不够稳定
当然,Reimagine有其局限。
最大缺点是它不按照原prompt来创造影像。
而且呢,其表现并不是那么稳,时而惊艳、时而更有拉跨感。
此外,尽管Stability AI将过滤器装到模型里以屏蔽不合适的要求,但是这并非无所不能。
此外,所有AI模型也不能回避偏见问题,Reimagine同样无法回避,Stability AI现正搜集用户反馈信息,希望可以缓解偏见。
网友们已经玩疯了
而且网友自然也早已等不及要玩。
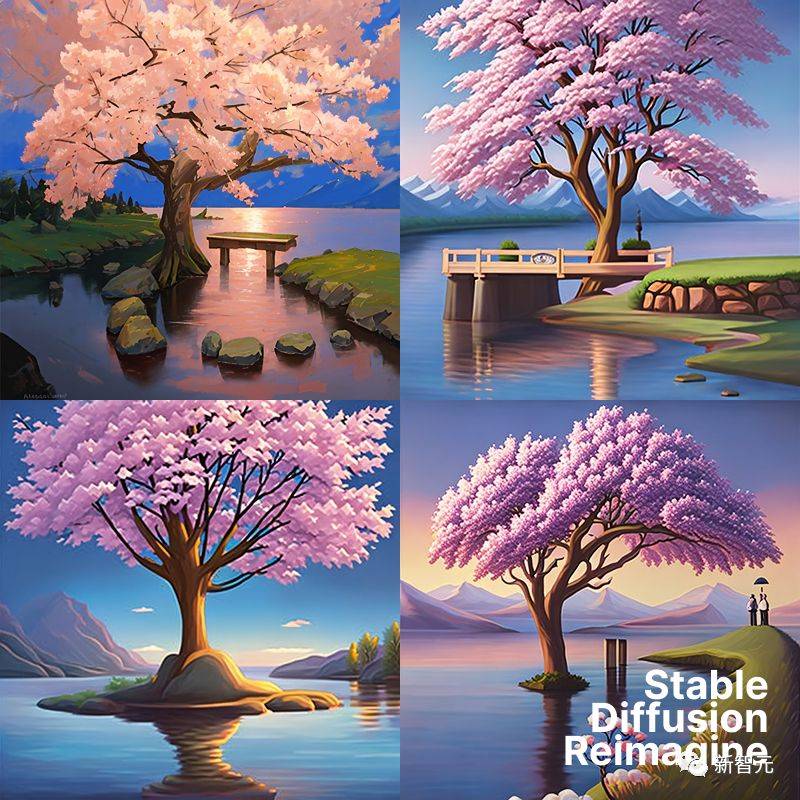
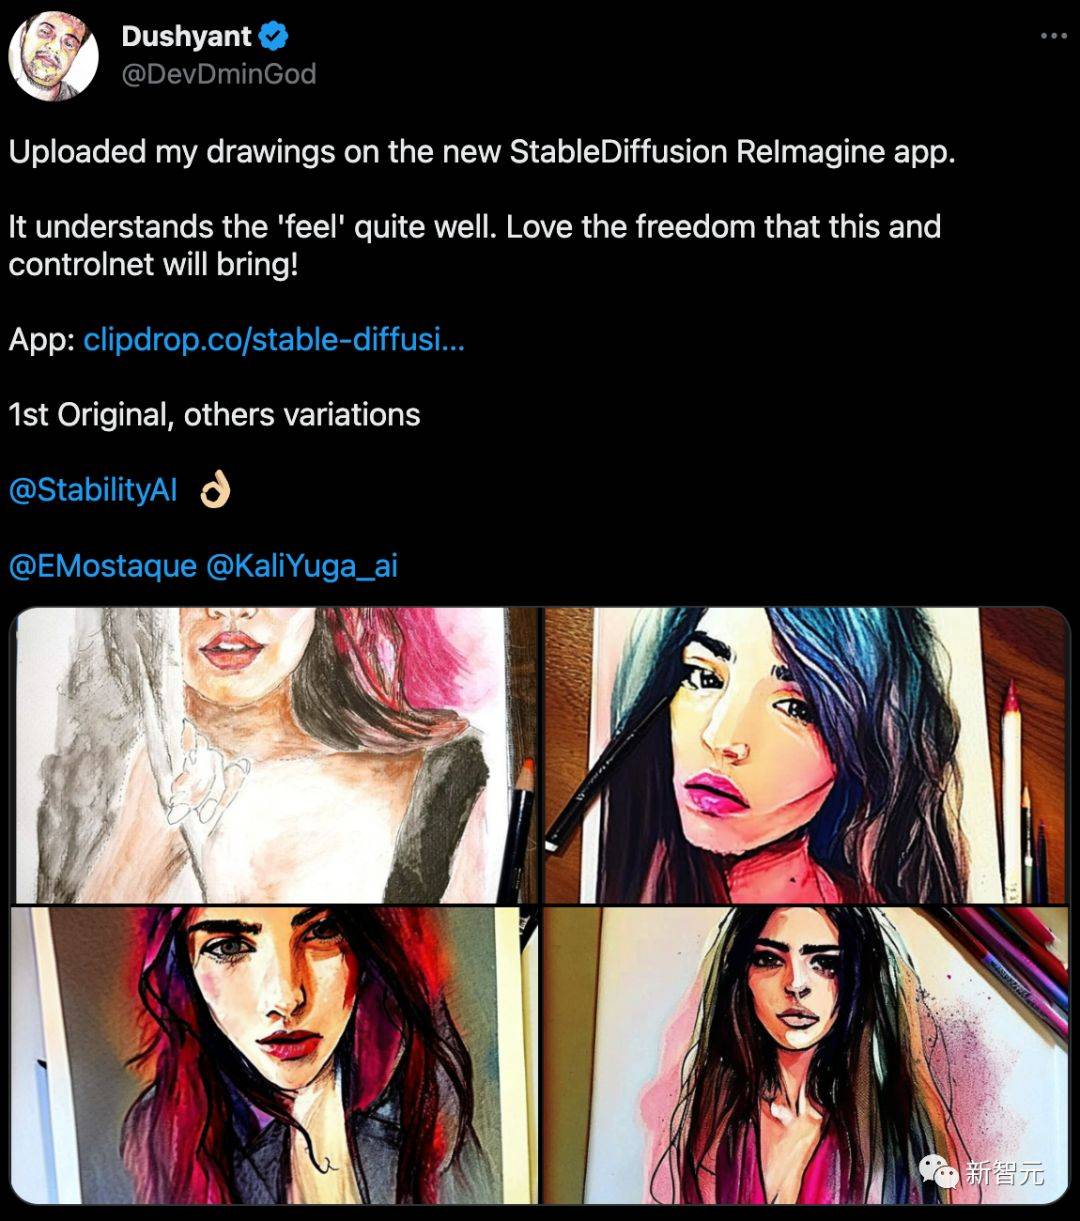
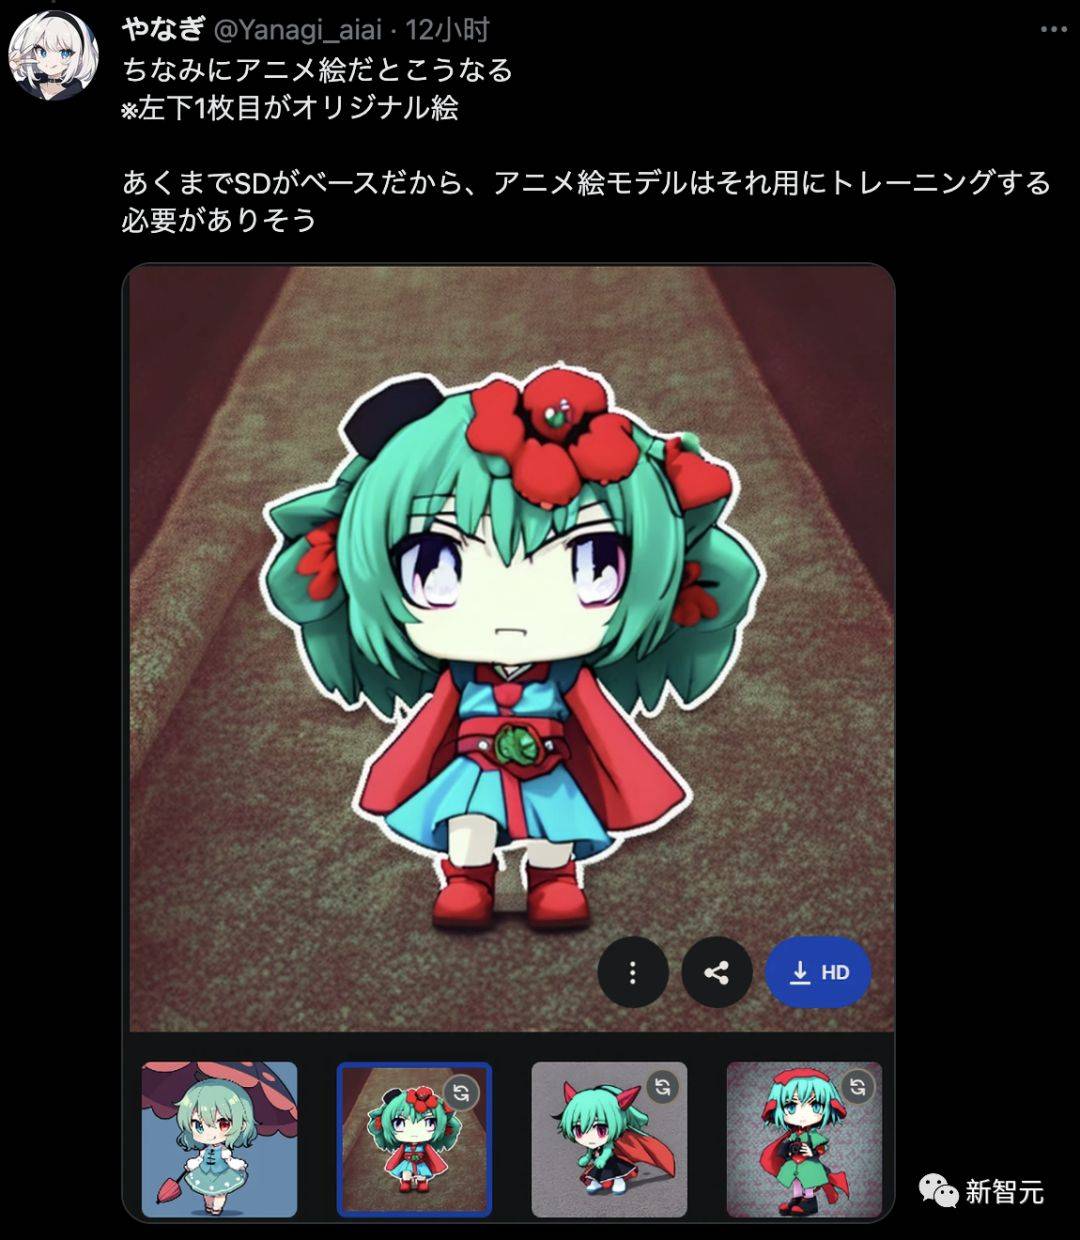
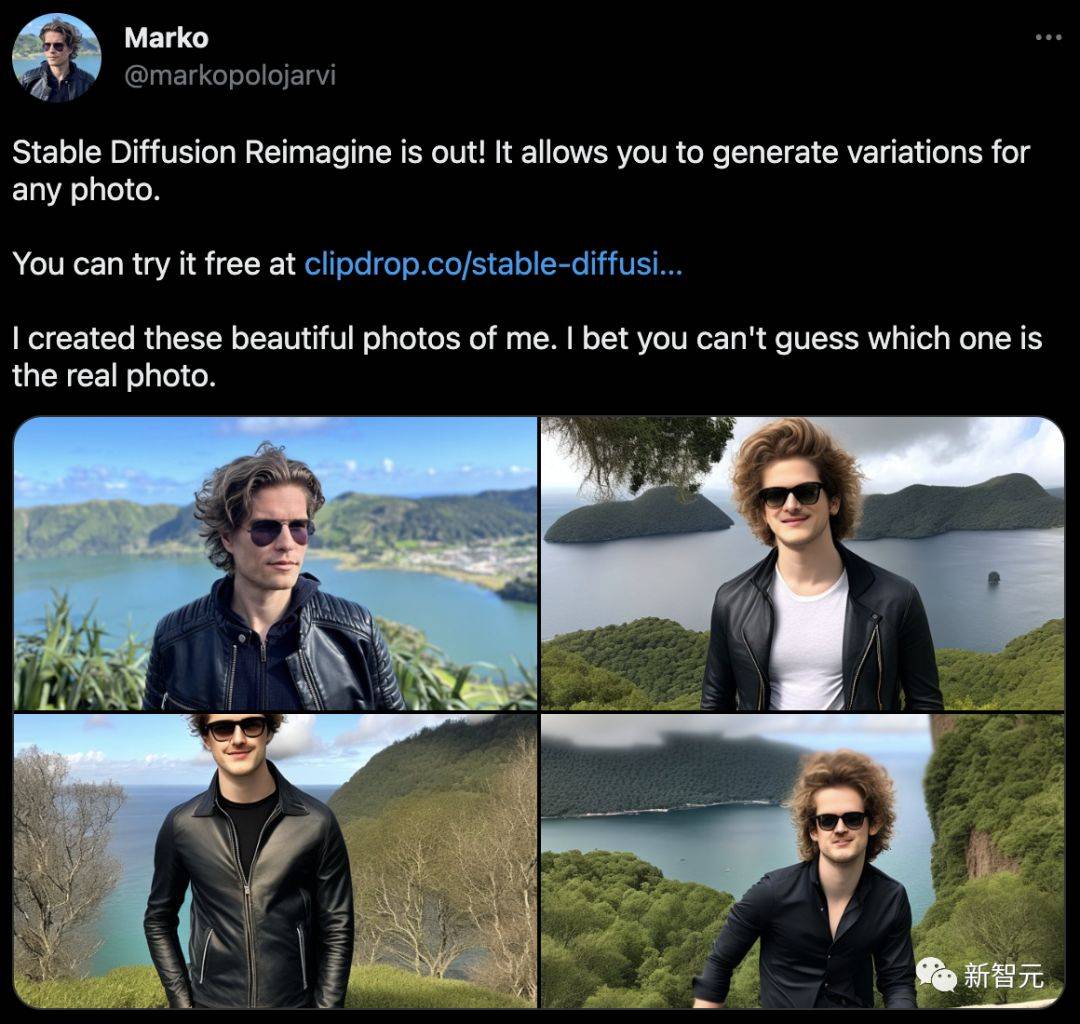
左上角的(或最左侧)为原始文件,其他照片则是在原始文件的启发下进行的「重新想象」。
从共享的作品中可以看出,成效最明显的的确还是设计:
Stable Diffusion Reimagine可以在不改变整体氛围的情况下,对全景图进行了再设计。
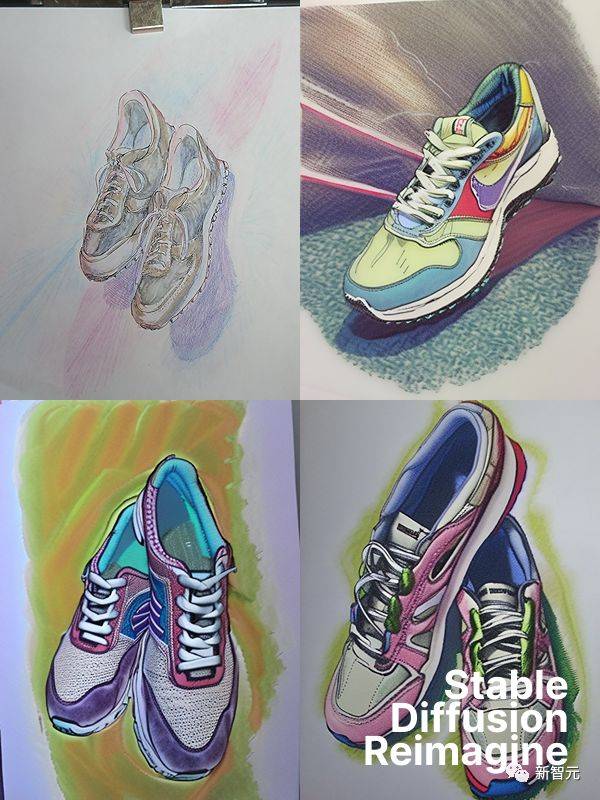
看得出Stable Diffusion Reimagine手绘作品处理方面,有很好的效果。
这位网友表示,它对「感觉」理解得相当好,自己很喜欢这种自由发挥的效果。
此外,Stable Diffusion Reimagine对二次元角色拿捏得也不错。
在真实场景中,有网友在尝试了自己的自拍之后大赞称:「我打赌你们绝对猜不到哪张照片是真的。」
不过小编试着做了些「名场面」,却发现是以下.
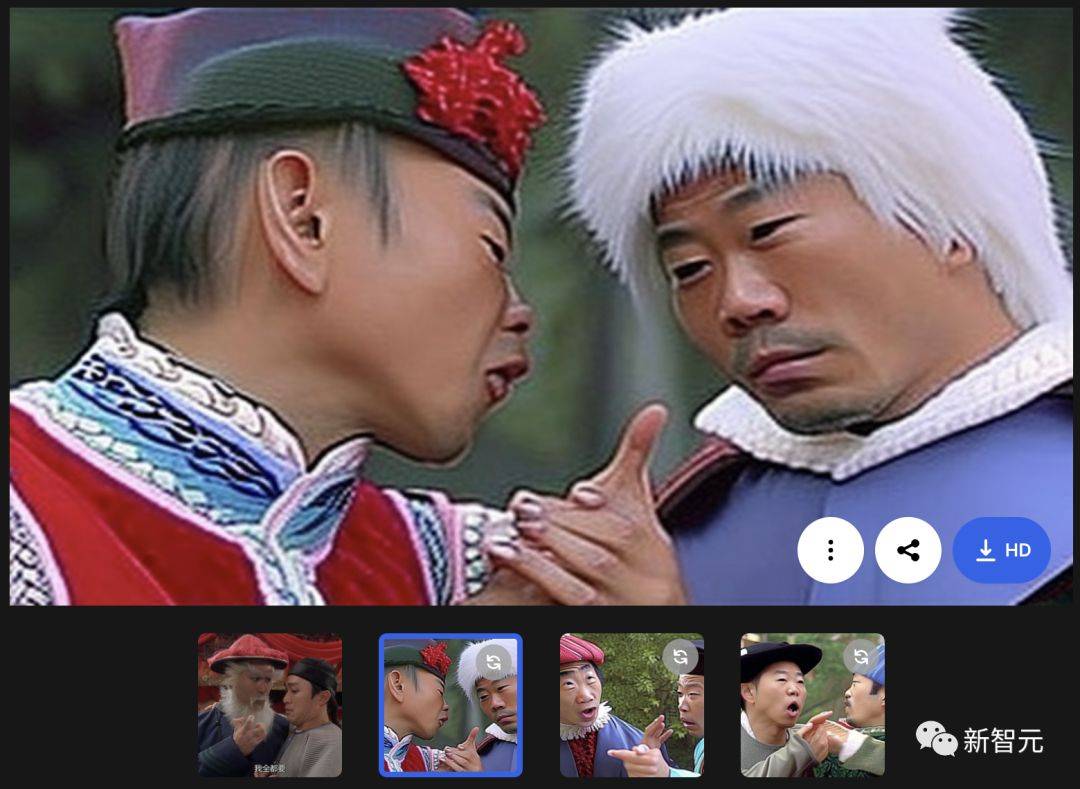
先输入《九品芝麻官》中的『我都想要』:
然后让Stable Diffusion「重新想象」一下:(这结果多少有些杀马特在里面)
换成威尔·史密斯愤怒地掴了奥斯卡的克里斯洛克一耳光试试看?
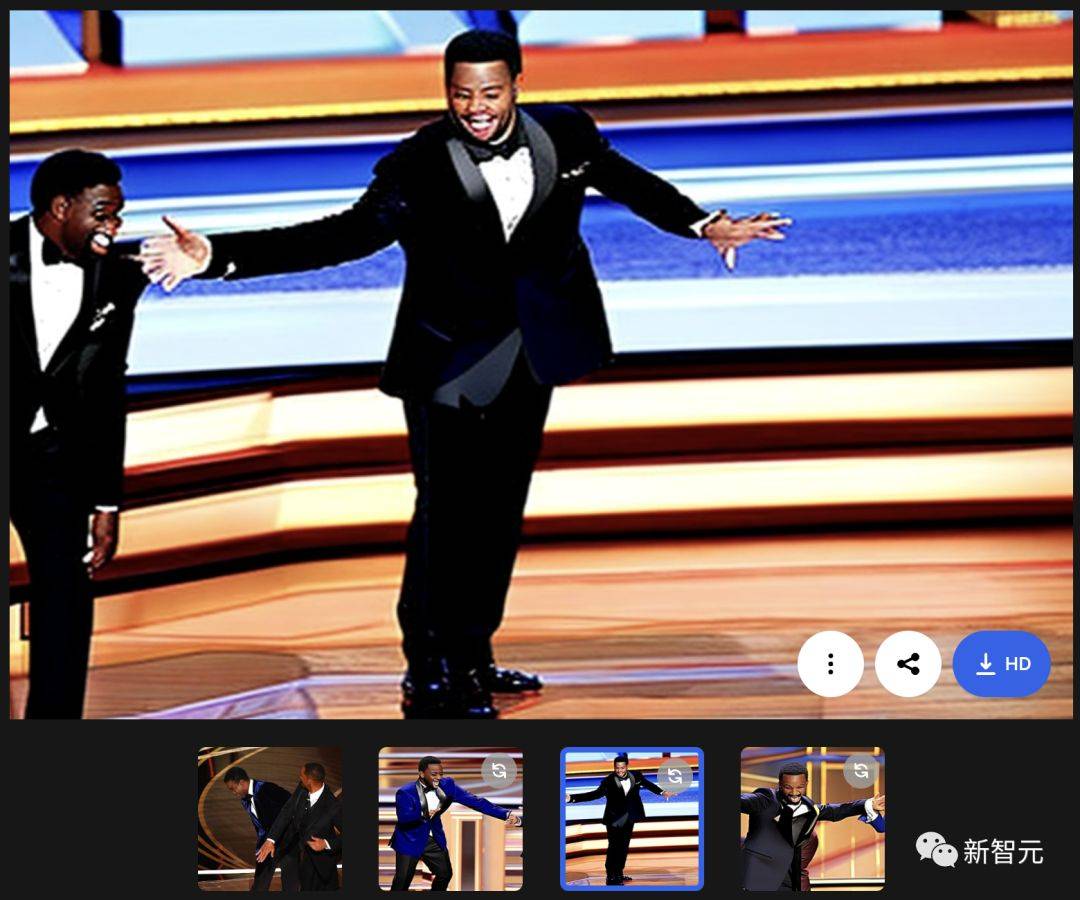
啊,这......
也许我们这种打开方式错了,终究,Stability AI主要用途协助设计师只需一张图片,即可得到相似的选择。
那么,我们就用它们给出的案例来做个测试吧。
请留意,以下为正式示范:
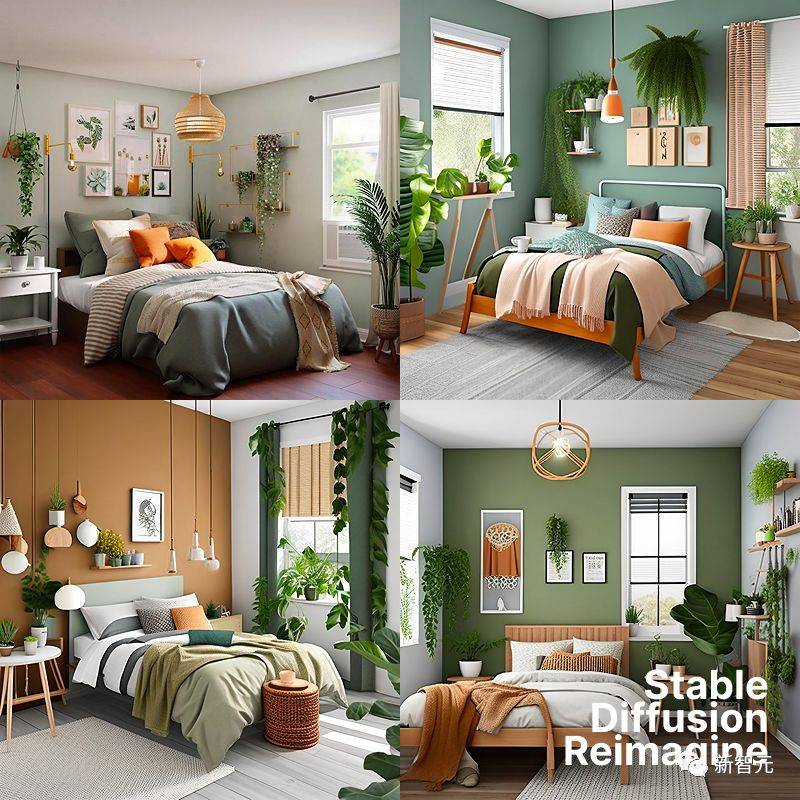
而以下这就是同一幅画的「复现」的效果.
很明显,Reimagine产生的画面看上去远不是那么真实,其比例非常奇特。
经过几次试验,我们仍未获得看上去完全逼真的照片。
针对这一情况,一些网友试穿后还称,Stable Diffusion Reimagin生成图片的质量跟Midjourney的差距还是很大的。
由于Midjourney能够被社区产生的丰富反馈所优化,而这一点是Stable Diffusion难以比拟的。
AI画手最终会成为画手
而另外一位有实力的AI画手,Midjourney自然没有闲着。
周三,Midjourney发布消息说:我们已将版本提升至第五版!
与前几版相比,V5版本图像质量较高、输出更加多样化、具有较宽的样式、支持无缝的纹理、具有较宽纵横比、具有较好的图像提示,及较宽广动态范围.
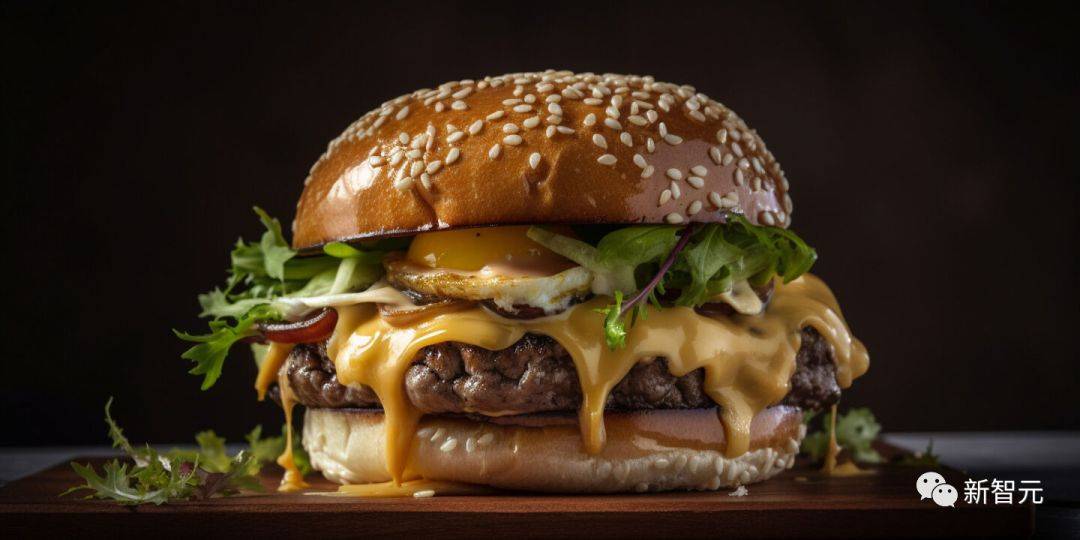
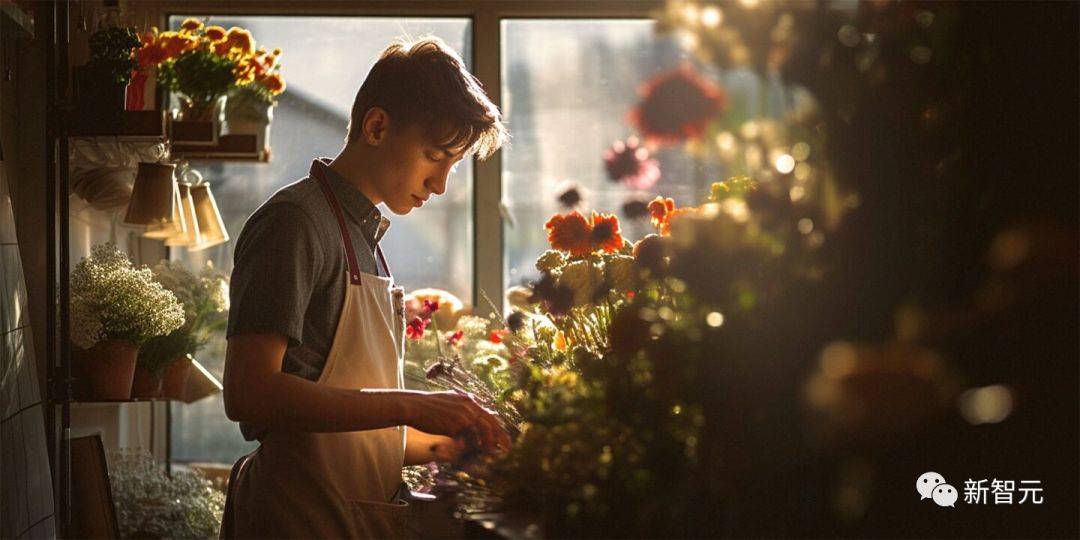
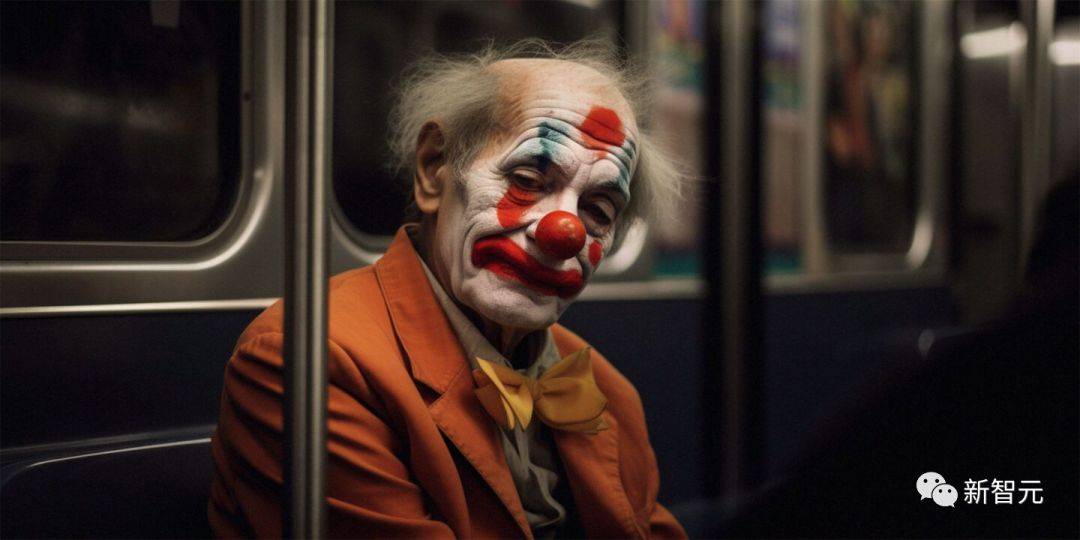
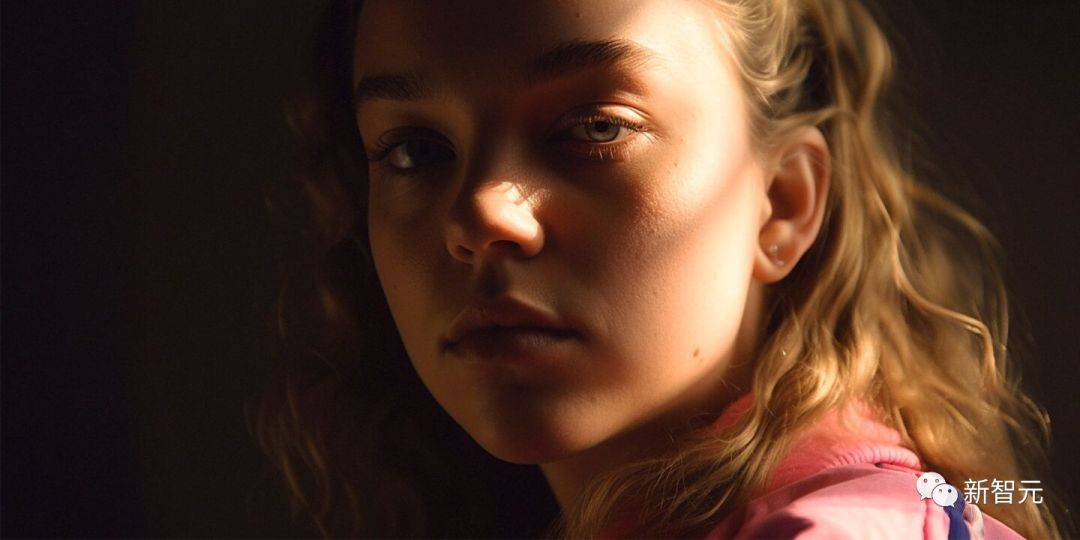
Midjourney V5的效果怎么说呢,AI艺术家们给出的评价是——「太逼真,太完美,以至于令人毛骨悚然。」
「仿佛一个近视眼忽然戴上了眼镜——画面忽然间就变成4k的了。」
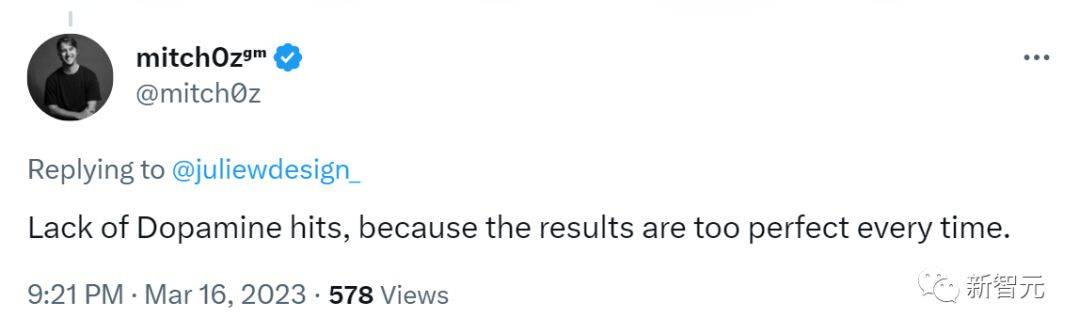
网友评价:由于每一次的完美和惊艳让多巴胺在结束时不再分泌
很显然,自从Midjourney在2022年3月份第一次出现之后,图像的细节方面总是不断地向前推进。这主要是因为他对摄影的理解和把握更加准确到位。第三版于去年8月份出版,第四版于11月出版,3月份便已发行第五版。
输入这样的prompt’肌肉发达的野蛮人拿着武器,电影,8K和演播室照明,v3和v4就在CRT电视机旁边、v5所产生的影像顺序为—
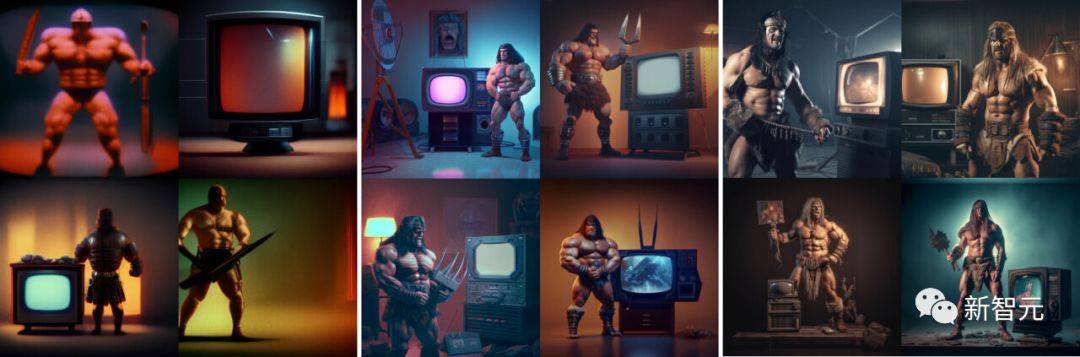
Midjourney v3(左)、v4(中)和 v5(右) Midjourney v3(左)、v4(中)和 v5(右)
不过最为惊人的升级是在人手方面的加工。
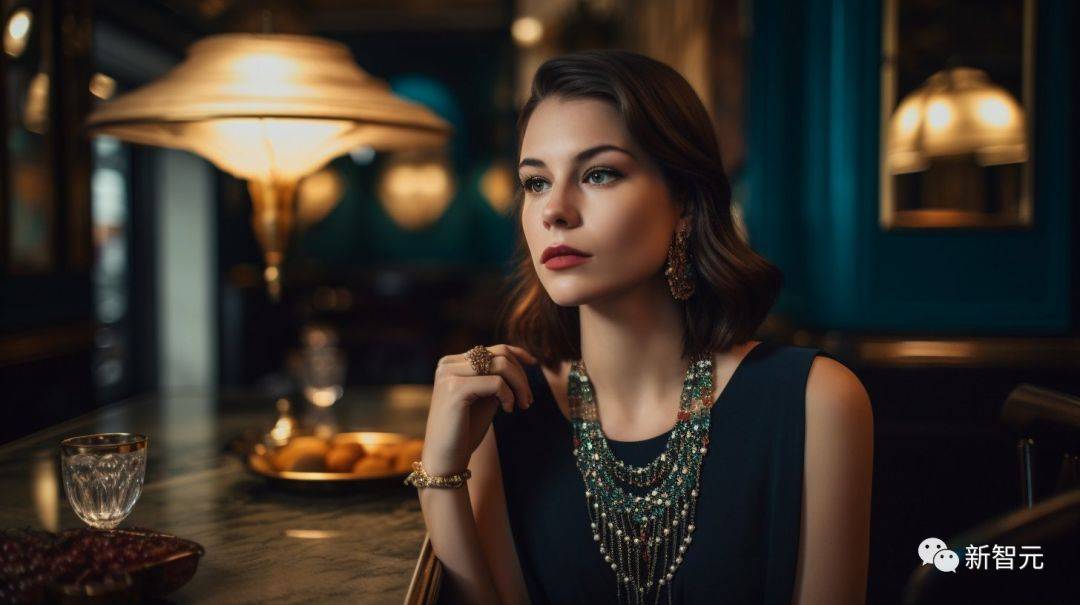
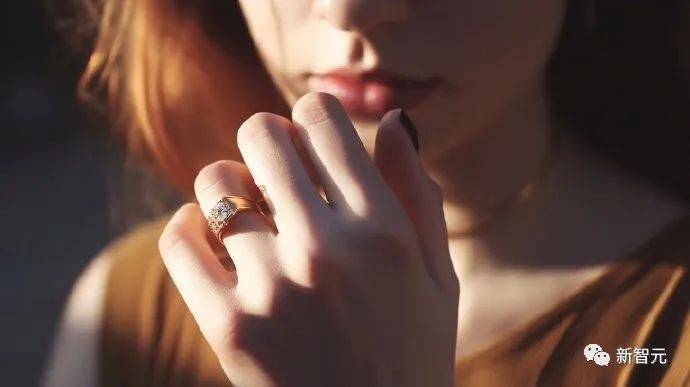
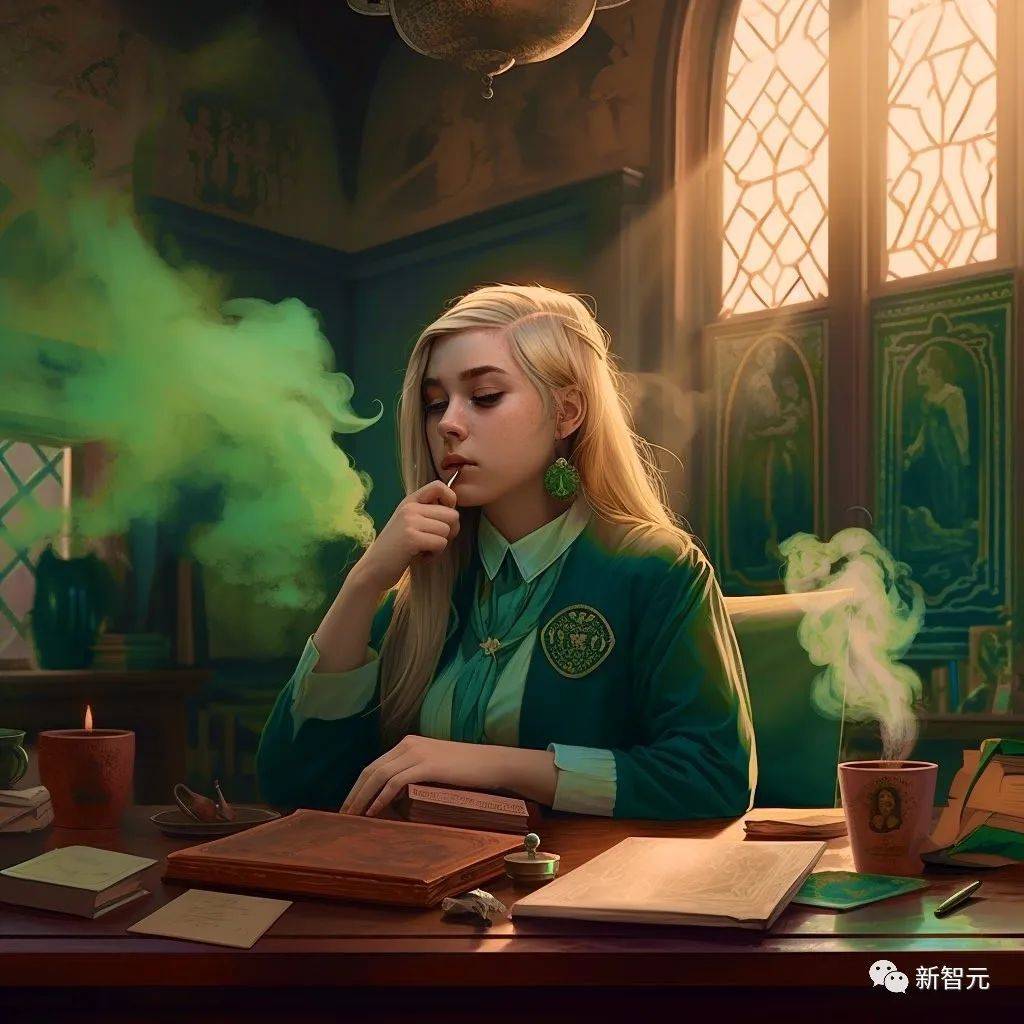
nice!
众所周知,Midjourney、Stable Diffusion和DALL-E等模型,均接受过数以百万计人类艺术家的创作培训。
为了构建LAION-5B数据集,AI研究者指导的机器人爬取了数十亿个网站,包括DeviantArt、ArtStation、Pinterest、Getty Images等的大型图像库,并且搜集到数以百万计的图片。
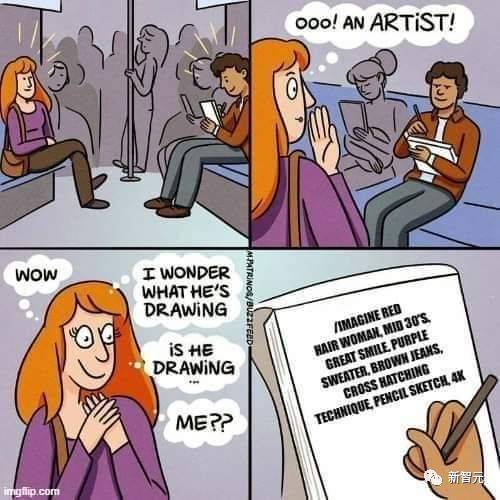
不过,即使这样,AI画手还是没有学过画手的本领。
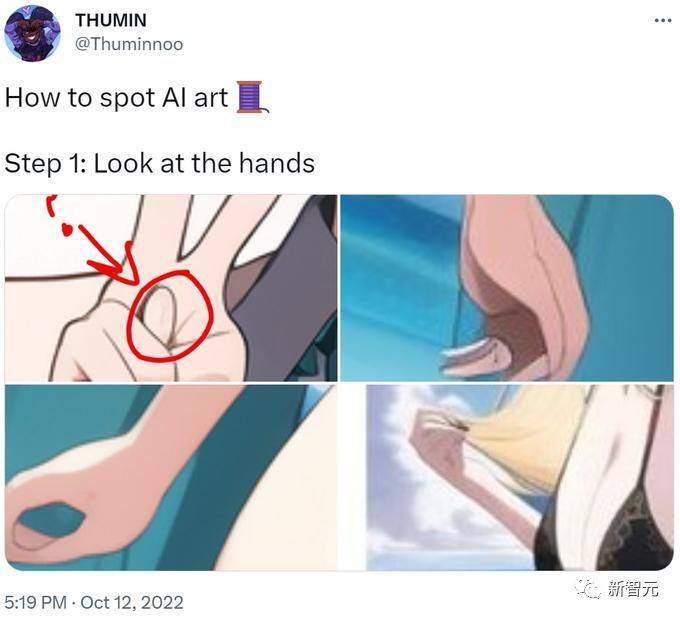
就连人物和景物也到了真真假假的地步了,只需把手放大,基本上一秒就能破功了。
网友表示,从不露面的美女自拍大多是AI做的。
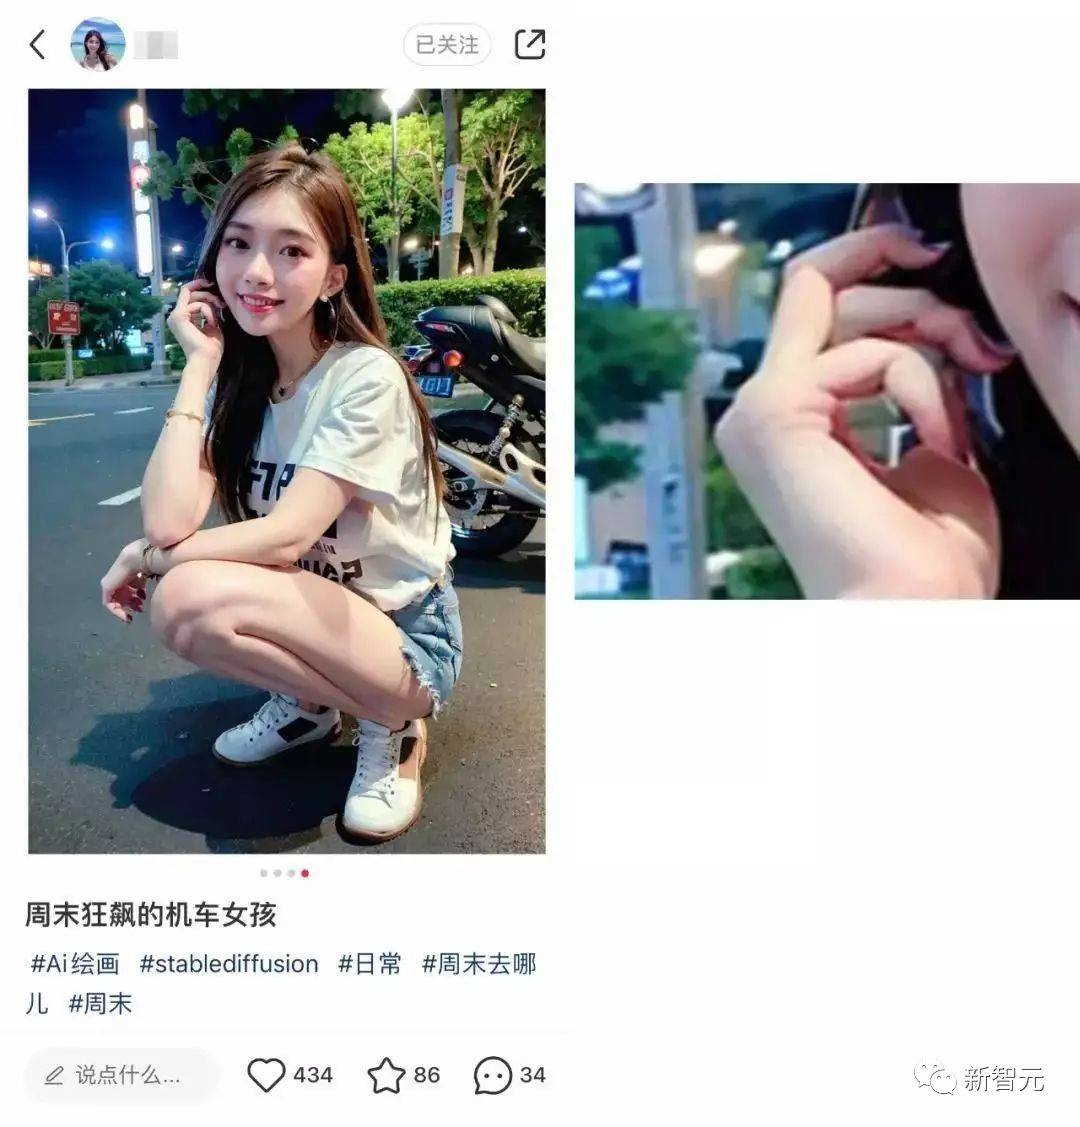
为什么会这样?
Stability AI的解释是,AI数据集上,人的双手没有面部那么引人注目;手比眼睛大一些,但是它并不总是与人相对应。原始图像上的手通常非常小,几乎没有多大形态。
佛罗里达大学AI和艺术教授Amelia Winger-Bearskin的解释是,AI们并不能真正理解什么是手,不了解其与解剖学中的人体有何联系。
以及Wieland的研究结果,多数情况下,Midjourney v5,均可画五指之手,而非7至10个指。
而且AI会画画手以后,网络上出现什么图片,也是真真假假。
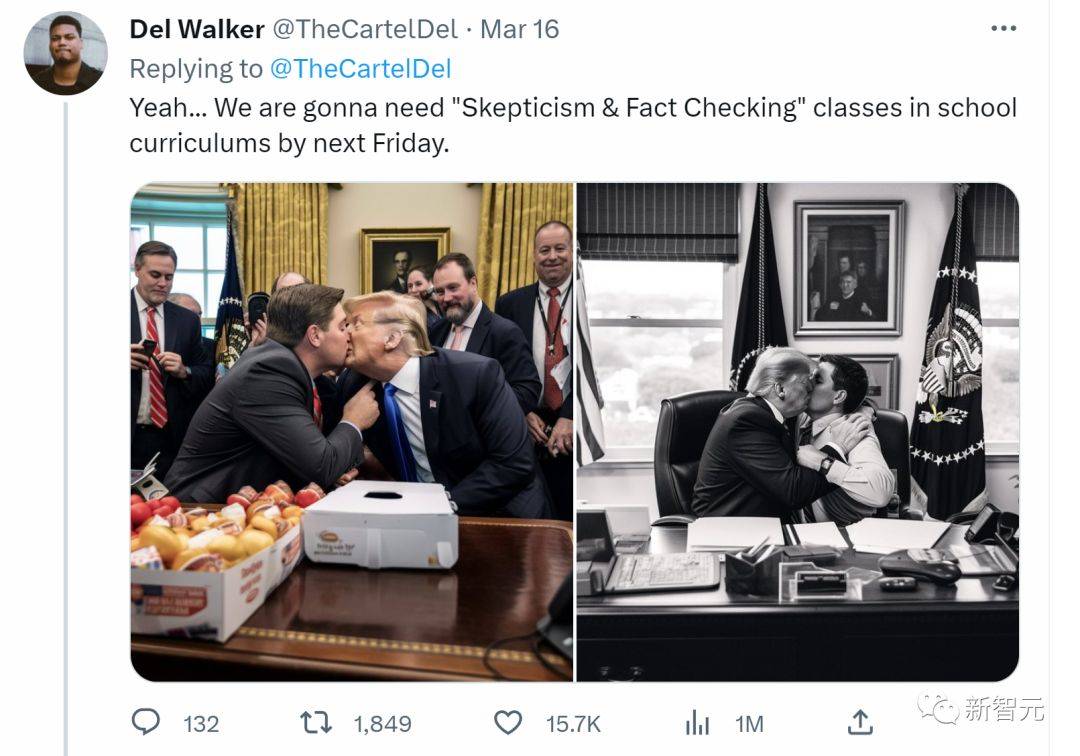
非说不可的话,Midjourney V5的不足之处,估计是真实的,完美的,还让我们失去了在经过几次努力之后,寻找最佳效果的乐趣。